Rujukan imej, video dan audio dalam satu prompt
MiniMax H3 menerima sehingga 9 imej rujukan, 3 video rujukan dan 3 klip audio dalam satu penjanaan, dan membacanya serentak, bukan satu demi satu. Dalam contoh MiniMax sendiri, model diminta dalam satu ayat untuk meniru gerakan kamera daripada video, membuat watak daripada imej menyanyi dan menyelaraskan vokal dengan klip audio. Dalam prompt itulah anda nyatakan fungsi setiap rujukan: "kekalkan wajah dan baju sejuk biru tua daripada potret, ikut gerakan dolly dalam video rujukan, dan biar dia menyanyikan melodi daripada klip audio di pelabuhan pada waktu senja". Tanpa ayat itu, model terpaksa meneka input mana yang mengawal apa. Rujukan dan bingkai pertama atau akhir tidak boleh digabungkan dalam satu penjanaan, jadi pilih satu pendekatan bagi setiap klip, dan pilih H3 dalam menu model untuk klip yang dibina berdasarkan rujukan. Gunakan bahan anda sendiri atau bahan yang anda ada kebenaran untuk digunakan, terutamanya bagi wajah dan suara.
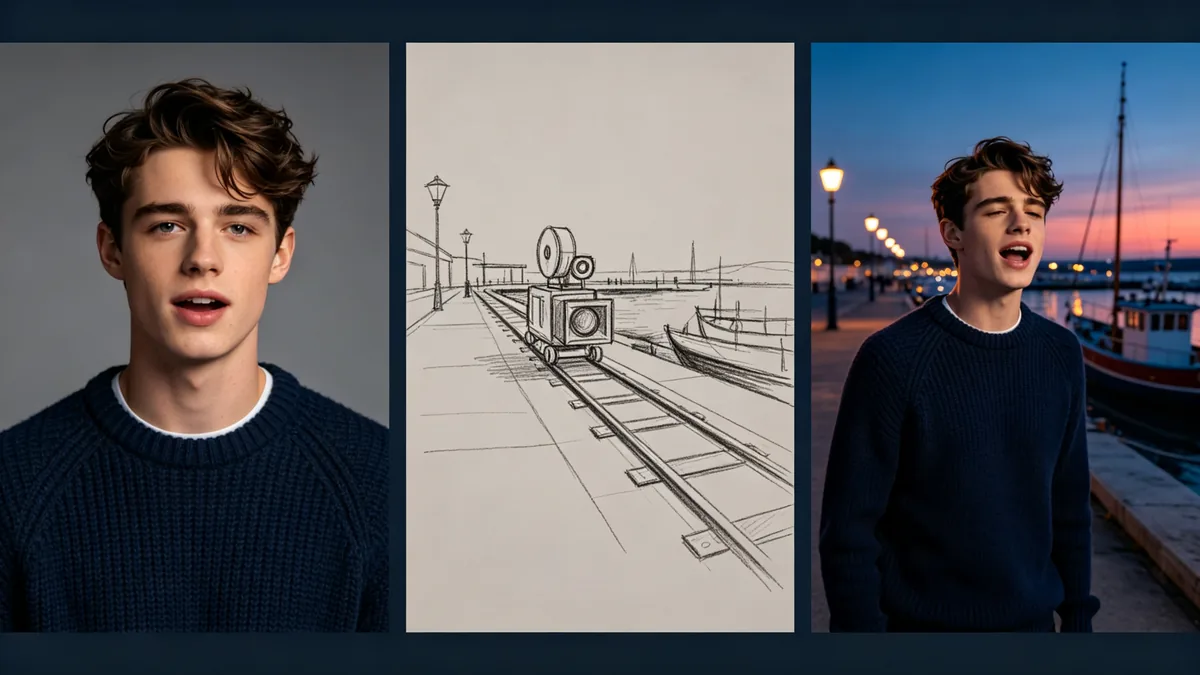
Bingkai utama video sinematik 16:9, triptik tiga panel yang dipisahkan oleh jalur gelap nipis: kiri, potret studio ringkas seorang lelaki muda berbaju sejuk kait biru tua berlatarkan kelabu; tengah, lakaran papan cerita pensel sebuah kamera yang bergerak di sepanjang dermaga pelabuhan; kanan, lelaki muda yang sama dengan baju sejuk biru tua yang sama menyanyi di dermaga pelabuhan pada waktu senja sementara kamera bergerak di sisinya, bot yang ditambat dan lampu di belakang. Wajah dan pakaian yang konsisten di semua panel, palet biru pekat dan koral, tiada teks, tiada logo.