Beeld-, video- en audioreferenties in één prompt
MiniMax H3 neemt in één generatie tot 9 referentieafbeeldingen, 3 referentievideo's en 3 audioclips aan, en leest ze samen in plaats van één voor één. In het voorbeeld van MiniMax zelf moet het model in één zin de camerabeweging uit een video overnemen, het personage uit een afbeelding laten zingen en de zang afstemmen op een audioclip. In de prompt zeg je waar elke referentie voor dient: "houd het gezicht en de marineblauwe trui uit het portret, volg de dollybeweging uit de referentievideo en laat hem bij schemering in de haven de melodie uit de audioclip zingen". Zonder die zin moet het model raden welke input wat bepaalt. Referenties en een eerste of laatste frame kun je niet in één generatie combineren, dus kies per clip één aanpak, en kies H3 in het modelmenu voor clips die op referenties zijn gebouwd. Gebruik je eigen materiaal of materiaal waarvoor je toestemming hebt, zeker bij gezichten en stemmen.
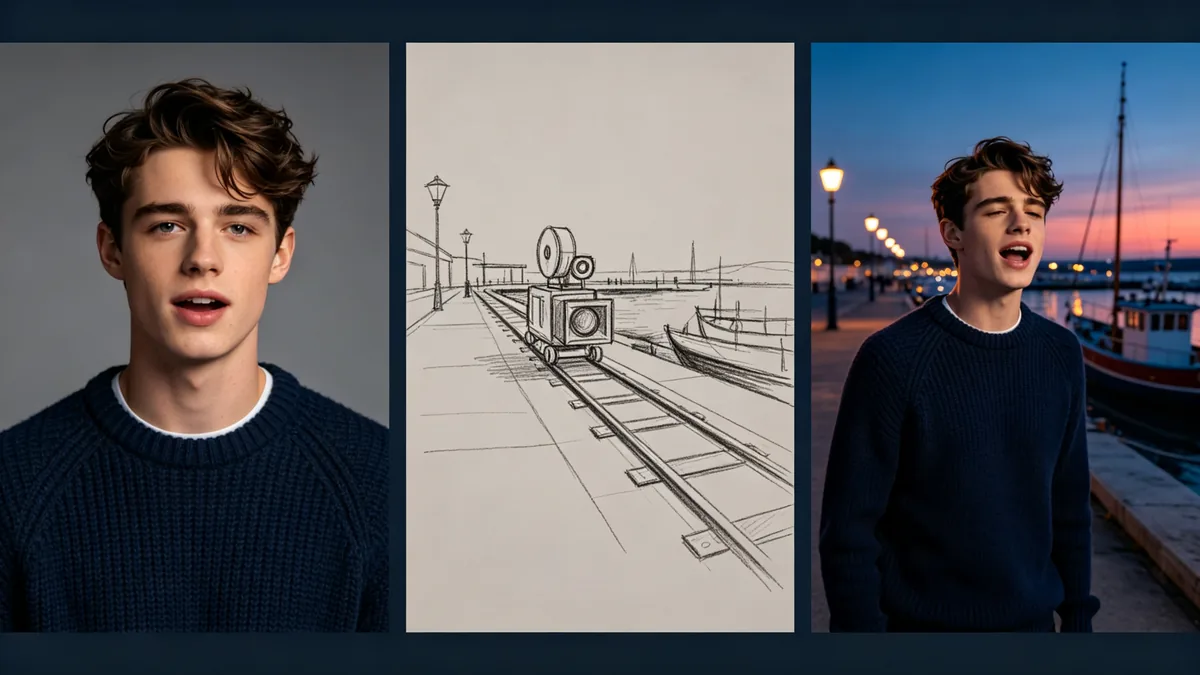
Filmisch 16:9-videokeyframe, een drieluik van drie panelen gescheiden door smalle donkere randen: links een eenvoudig studioportret van een jonge man in een marineblauwe gebreide trui voor een grijze achtergrond; in het midden een storyboardschets in potlood van een camera die op een dolly langs een havenkade rijdt; rechts dezelfde jonge man in dezelfde marineblauwe trui die bij schemering op de havenkade zingt terwijl de camera naast hem meebeweegt, met afgemeerde boten en lantaarns erachter. Gezicht en kleding gelijk in alle panelen, palet van diepblauw en koraal, geen tekst, geen logo's.