Bild-, video- och ljudreferenser i en och samma prompt
MiniMax H3 tar emot upp till 9 referensbilder, 3 referensvideor och 3 ljudklipp i en generering och läser dem tillsammans i stället för en i taget. I ett exempel från MiniMax själva ombeds modellen i en enda mening att kopiera kamerarörelsen från en video, låta karaktären från en bild sjunga och matcha sången mot ett ljudklipp. Det är i prompten du talar om vad varje referens ska användas till: ”behåll ansiktet och den marinblå tröjan från porträttet, följ kameraåkningen i referensvideon och låt honom sjunga melodin från ljudklippet i hamnen i skymningen”. Utan den meningen måste modellen gissa vilken indata som styr vad. Referenser och en första eller sista bildruta kan inte kombineras i en generering, så välj ett arbetssätt per klipp, och välj H3 i modellmenyn för klipp som bygger på referenser. Använd eget material eller material du har tillstånd att använda, särskilt när det gäller ansikten och röster.
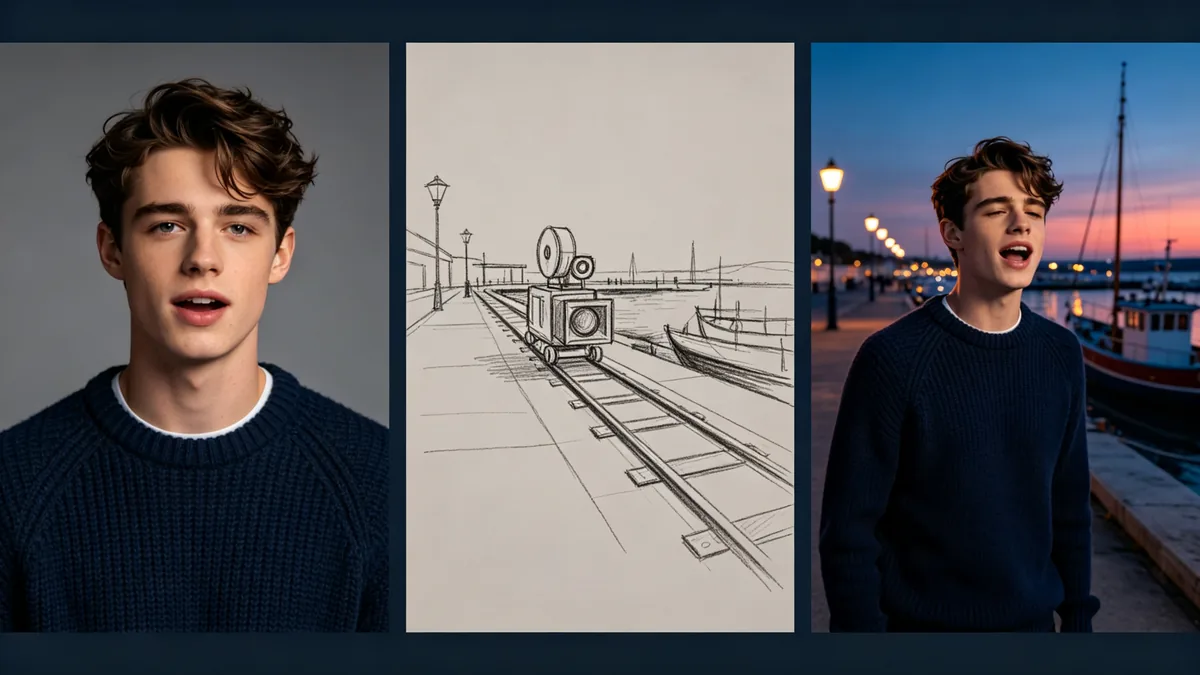
Filmisk nyckelbild för video i 16:9, en triptyk med tre paneler åtskilda av tunna mörka ränder: till vänster ett enkelt studioporträtt av en ung man i en marinblå stickad tröja mot en grå bakgrund; i mitten en storyboardskiss i blyerts av en kamera som åker längs en hamnkaj; till höger samma unga man i samma marinblå tröja som sjunger på hamnkajen i skymningen medan kameran rör sig bredvid honom, förtöjda båtar och lyktor bakom. Samma ansikte och kläder i alla paneler, palett i djupblått och korall, ingen text, inga logotyper.