एक प्रॉम्प्ट में इमेज, वीडियो और ऑडियो रेफ़रेंस
MiniMax H3 एक जनरेशन में 9 तक रेफ़रेंस इमेज, 3 रेफ़रेंस वीडियो और 3 ऑडियो क्लिप लेता है, और इन्हें एक-एक करके नहीं, बल्कि एक साथ पढ़ता है। MiniMax के अपने उदाहरण में मॉडल से एक ही वाक्य में कहा जाता है कि वह वीडियो से कैमरा मूवमेंट कॉपी करे, इमेज वाले किरदार से गाना गवाए और आवाज़ को एक ऑडियो क्लिप से मिलाए। हर रेफ़रेंस किस काम का है, यह आप प्रॉम्प्ट में ही बताते हैं: "पोर्ट्रेट से चेहरा और नेवी स्वेटर वैसा ही रखो, रेफ़रेंस वीडियो की डॉली मूवमेंट को फ़ॉलो करो, और उसे शाम के धुंधलके में बंदरगाह पर ऑडियो क्लिप वाली धुन गाने दो"। यह वाक्य न हो तो मॉडल को अंदाज़ा लगाना पड़ता है कि कौन-सा इनपुट किस चीज़ को कंट्रोल करता है। एक जनरेशन में रेफ़रेंस और पहला या आख़िरी फ़्रेम साथ नहीं चल सकते, इसलिए हर क्लिप के लिए एक ही तरीका चुनें, और रेफ़रेंस पर आधारित क्लिप के लिए मॉडल मेन्यू में H3 चुनें। अपना मटीरियल इस्तेमाल करें या ऐसा मटीरियल जिसकी आपके पास अनुमति हो, ख़ासकर चेहरों और आवाज़ों के मामले में।
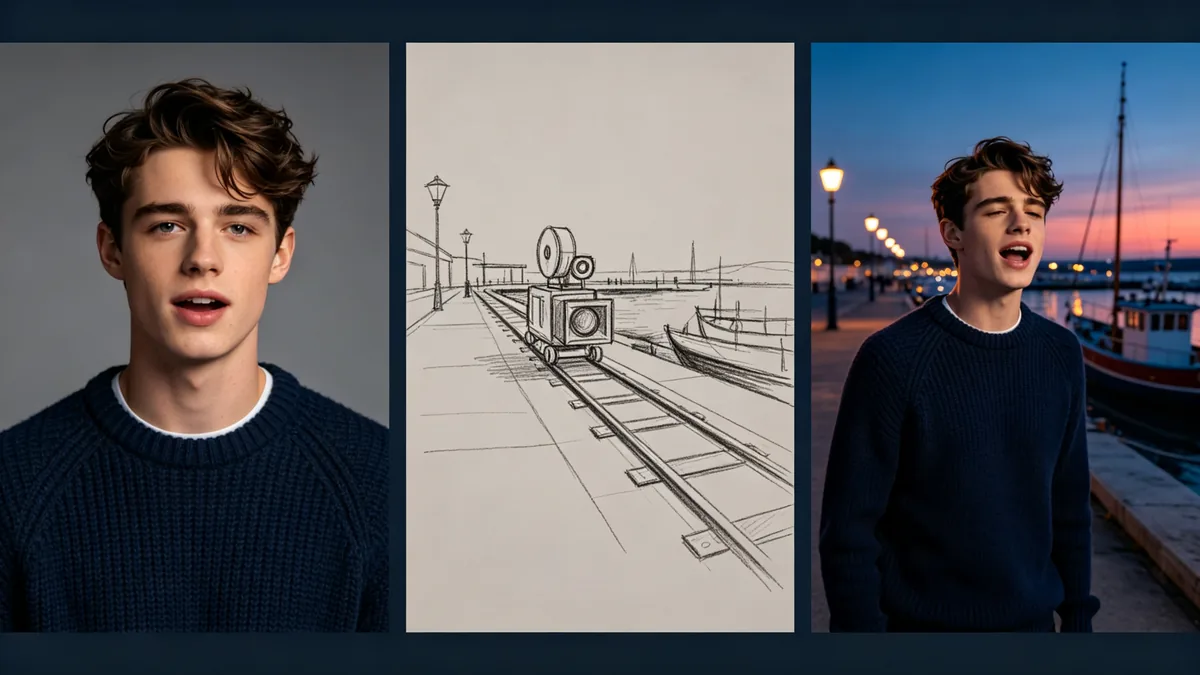
सिनेमैटिक 16:9 वीडियो कीफ़्रेम, पतली गहरी पट्टियों से अलग तीन पैनल वाला ट्रिप्टिक: बाईं ओर ग्रे बैकग्राउंड पर नेवी बुने हुए स्वेटर में एक युवक का सादा स्टूडियो पोर्ट्रेट; बीच में बंदरगाह के घाट के साथ डॉली करते कैमरे का पेंसिल स्टोरीबोर्ड स्केच; दाईं ओर वही युवक उसी नेवी स्वेटर में शाम के धुंधलके में घाट पर गाता हुआ, कैमरा उसके साथ-साथ चलता हुआ, पीछे बँधी हुई नावें और लैंप। सभी पैनल में एक जैसा चेहरा और कपड़े, गहरे नीले और कोरल का पैलेट, कोई टेक्स्ट या लोगो नहीं।