Références image, vidéo et audio dans un seul prompt
MiniMax H3 accepte jusqu'à 9 images de référence, 3 vidéos de référence et 3 clips audio par génération, et les lit ensemble plutôt qu'une par une. Dans l'exemple donné par MiniMax, le modèle doit reprendre le mouvement de caméra d'une vidéo, faire chanter le personnage d'une image et caler la voix sur un clip audio, le tout en une seule phrase. C'est dans le prompt que vous dites à quoi sert chaque référence : « garde le visage et le pull bleu marine du portrait, suis le travelling de la vidéo de référence et fais-lui chanter la mélodie du clip audio sur le port au crépuscule ». Sans cette phrase, le modèle doit deviner quelle entrée contrôle quoi. Les références et une première ou dernière image ne se combinent pas dans une même génération : choisissez donc une approche par clip, et sélectionnez H3 dans le menu des modèles pour les clips construits sur des références. Utilisez vos propres contenus, ou des contenus que vous avez le droit d'utiliser, surtout pour les visages et les voix.
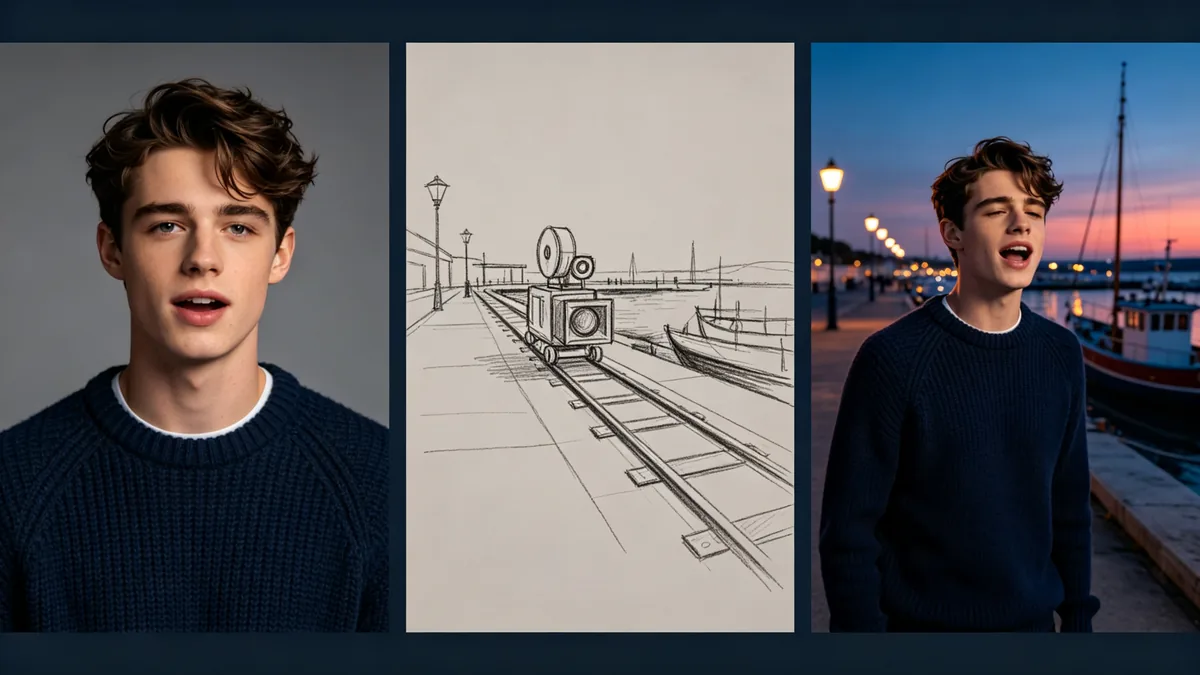
Image clé vidéo cinématographique en 16:9, un triptyque de trois panneaux séparés par de fines marges sombres : à gauche, un portrait de studio sobre d'un jeune homme en pull en maille bleu marine devant un fond gris ; au centre, un storyboard au crayon d'une caméra en travelling le long d'un quai de port ; à droite, le même jeune homme dans le même pull bleu marine qui chante sur le quai au crépuscule pendant que la caméra se déplace à côté de lui, des bateaux amarrés et des lampadaires derrière. Visage et vêtements identiques d'un panneau à l'autre, palette bleu profond et corail, pas de texte, pas de logos.