Bild-, Video- und Audioreferenzen in einem Prompt
MiniMax H3 nimmt bis zu 9 Referenzbilder, 3 Referenzvideos und 3 Audioclips pro Generierung und liest sie gemeinsam statt nacheinander.
Im Beispiel von MiniMax soll das Modell in einem einzigen Satz die Kamerafahrt aus einem Video übernehmen, die Figur aus einem Bild singen lassen und den Gesang an einen Audioclip anpassen.
Sag im Prompt, wofür jede Referenz da ist, sonst muss das Modell raten: „Behalte das Gesicht aus dem Porträt, folge der Dolly-Fahrt aus dem Referenzvideo und lass ihn die Melodie aus dem Audioclip singen“.
Referenzen und ein erster oder letzter Frame lassen sich nicht in einer Generierung kombinieren. Entscheide dich also pro Clip für einen Weg und wähl für Clips mit Referenzen H3.
Verwende eigenes Material oder Material, für das du die Erlaubnis hast, besonders bei Gesichtern und Stimmen.
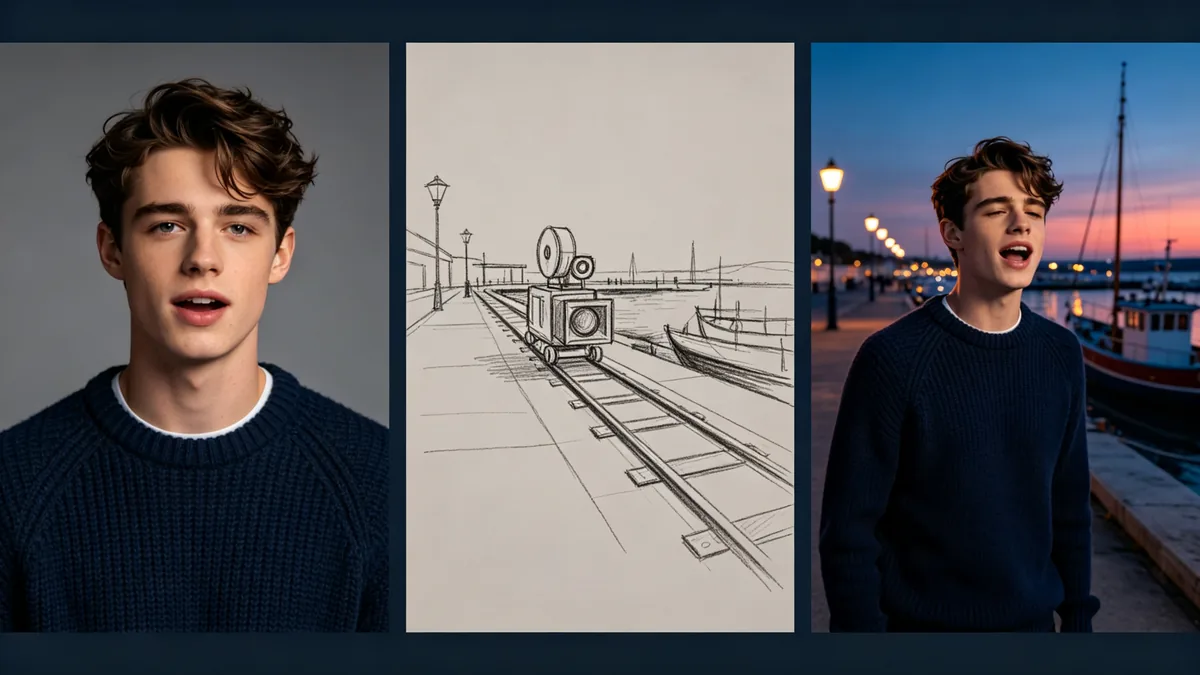
Filmisches 16:9-Video-Keyframe, ein Triptychon aus drei Feldern, getrennt durch schmale dunkle Stege: links ein schlichtes Studioporträt eines jungen Mannes in einem marineblauen Strickpullover vor grauem Hintergrund; in der Mitte eine Storyboard-Bleistiftskizze einer Kamera, die auf einem Dolly an einem Hafenkai entlangfährt; rechts derselbe junge Mann im selben marineblauen Pullover, der in der Abenddämmerung auf dem Hafenkai singt, während die Kamera neben ihm mitfährt, dahinter vertäute Boote und Laternen. Gesicht und Kleidung in allen Feldern gleich, Farbpalette aus Tiefblau und Koralle, kein Text, keine Logos.